 Разработка на 1С-Битрикс
Семантический поиск понимает смысл запроса, а не ищет точное совпадение слов. Покупатель пишет чем косить траву на даче
- магазин показывает газонокосилки и триммеры, даже если в названии товара нет слова косить
.
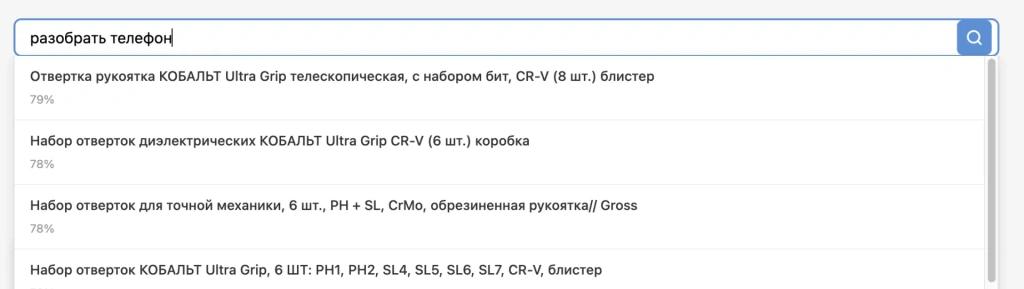
Пример работы и видео
Внимание! в видео рассказываю про предыдущую версию модуля: она полагалась на индексы поиска 1С-Битрикс и работала на модели intfloat/multilingual-e5-base. В репозитории новая версия - у неё свои индексы напрямую из инфоблока и модель Google EmbeddingGemma 300M (точнее на русском, длиннее контекст, в разы меньше памяти).
Настроить модуль на вашем сайте: от 25 000 руб. первую индексацию провожу на своем мощном сервере.
Штатный поиск 1С-Битрикс работает по прямому совпадению слов. Написал крем от морщин после 45
- получил пустую выдачу, потому что в названиях товаров нет слова морщин
, а есть антивозрастной
или anti-age
. Нейросеть понимает, что это одно и то же.
Как устроен модуль
Под капотом - модель Google EmbeddingGemma 300M в формате ONNX с int8-квантизацией. Она превращает текст в вектор из 768 чисел (эмбеддинг). Чем ближе векторы двух текстов - тем они похожее по смыслу, даже если слова совершенно разные.
Модель мультиязычная (100+ языков, русский в том числе), контекст - 2048 токенов (текст товара обрезается до 4000 символов). Название товара подаётся отдельным полем title, описание и свойства - в text: так рекомендует карточка модели, и на практике это заметно повышает качество выдачи.
Ремарка про старую модель. Раньше модуль работал на intfloat/multilingual-e5-base под PyTorch. От неё отказались в пользу EmbeddingGemma по двум причинам:
• Меньше памяти. e5-base весит ~1.1 GB и требует torch-runtime (~400 MB), то есть ~1.5 GB RAM на сервис. EmbeddingGemma в int8 занимает ~316 MB и работает на ONNX Runtime без PyTorch.
• Больше контекста. У e5-base окно 512 токенов, у EmbeddingGemma - 2048 токенов. В карточку влезают и название, и описание, и все свойства (текст обрезается только на 4000 символах), тогда как у e5 длинного описания хватало ненадолго.
Плюс EmbeddingGemma заметно лучше на русском, поэтому и порог релевантности теперь другой - см. ниже.
Само собой, он может работать и в режиме обычного поиска c исправлением даже очень сильных опечаток, переставлением слов и написании в не правильной раскладке. Область применимости не только интернет магазины, может работать на информационных ресурсах и.т.д.
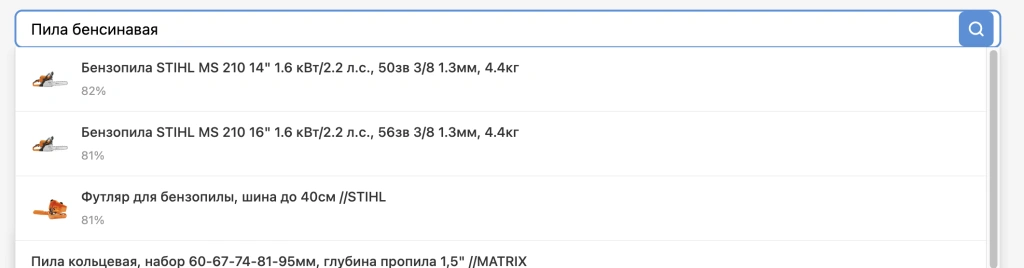
Модель работает через Python-сервис (server.py), который крутится на 127.0.0.1:9876. При поиске PHP отправляет запрос пользователя в Python, получает вектор и сравнивает его с заранее проиндексированными векторами товаров через косинусное сходство. Весь поиск - 0.3-1 секунда.
После первой индексации индекс обновляется автоматически: модуль регистрирует в 1С-Битрикс своего агента (b_agent), а ядро запускает агентов по своему крону (cron_events.php) - отдельную строку в crontab добавлять не нужно. Агент собирает тексты товаров напрямую из инфоблока (b_iblock_element: название, детальное описание и выбранные свойства), отправляет их пачками в Python-сервис, получает эмбеддинги и складывает их в таблицу mib_smartconsultant_embedding.
Требования к серверу
Модель EmbeddingGemma 300M в int8 весит ~316 MB и загружается в RAM при старте Python-сервиса. PyTorch и GPU не нужны - хватает ONNX Runtime на обычном CPU (достаточно даже AVX без AVX2, то есть железо 2011 года и новее).
Пик потребления Python-сервиса при индексации - около 2.6 GB RAM. Минимальные требования: 4 GB RAM, 2 ядра CPU. Рекомендуемые для каталога до 100 000 товаров: 8 GB RAM, 4 ядра. И обязательно Linux - Python-часть не работает на macOS (MAMP).
Место в БД: один товар = 3072 байта (768 float32). 10 000 товаров = 30 MB, 100 000 = 300 MB.
Установка и настройка
Подробная инструкция - в README.md модуля. Коротко:
# 1. Скачивание модели (плоская директория, не кэш HuggingFace)
pip install -U huggingface_hub   # CLI «hf»
mkdir -p /home/bitrix/embed_models/embeddinggemma-onnx-int8
hf download onnx-community/embeddinggemma-300m-ONNX \
  --local-dir /home/bitrix/embed_models/embeddinggemma-onnx-int8 \
  --include "model_quantized.onnx" "model_quantized.onnx_data" \
  --include "tokenizer.json" "tokenizer_config.json" "special_tokens_map.json" "config.json"

# 2. Python-окружение (torch НЕ нужен)
cd local/modules/mibazarow.smartconsultant/python
python3.11 -m venv venv
venv/bin/pip install -r requirements.txt   # flask, numpy, onnxruntime, transformers

# 3. Systemd-сервис (юнит и его переменные - в README модуля)
systemctl enable --now mib-smartconsultant
curl http://127.0.0.1:9876/health

# 4. Установка модуля в админке Битрикс
# Marketplace → Установленные решения → AI Консультант → Установить

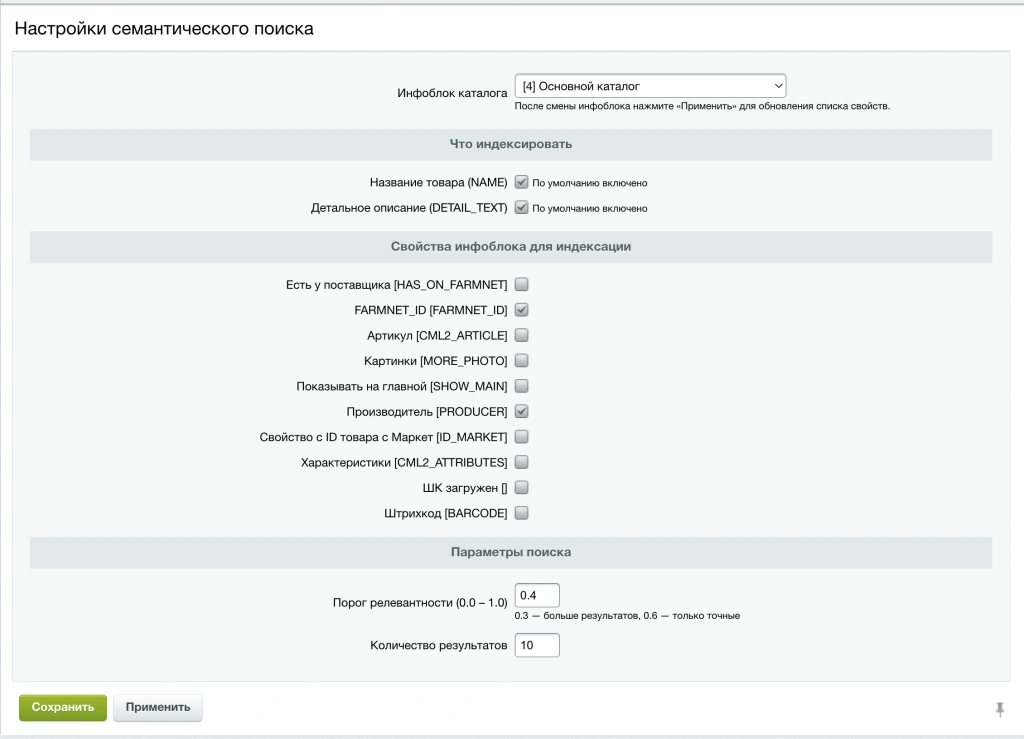
# 5. Настройка: выбрать инфоблок каталога, порог релевантности 0.30
# Админка → Настройки → Настройки модулей → AI Консультант

# 6. Первая индексация (на большом каталоге - в фоне: nohup / systemd-run)
php local/modules/mibazarow.smartconsultant/bin/reindex.php

# 7. Cron-строка НЕ нужна: дальше индекс обновляет агент модуля,
#    который ядро Битрикс запускает из cron_events.php
#    (полный проход - раз в сутки, незавершённый продолжается сразу)
Как работает индексация
Первая индексация - самая долгая. Для 60 000 товаров на 4-ядерном CPU (без GPU) это порядка 35 часов: каждый товар проходит через нейросеть небольшими пачками, чтобы не перегружать модель и память.
Последующие запуски - минуты. Модуль проверяет MD5-хеш текста каждого товара. Если текст не изменился - товар пропускается. Обрабатываются только новые и изменившиеся товары. Если агент не успел пройти весь каталог за один запуск (у ядра есть лимит времени на агента), проход продолжается с того же места - позиция хранится в настройке REINDEX_CURSOR.
Если 35 часов ждать не хочется, можно проиндексировать каталог на мощной машине (GPU-сборка ONNX Runtime или просто многоядерный CPU) - там это занимает минуты, - сделать mysqldump таблицы mib_smartconsultant_embedding и залить дамп на продакшен. Эмбеддинги - это просто числа, они не зависят от железа. Важно только, чтобы совпадала модель и размерность вектора.
Поисковый компонент
Компонент mibazarow:smartconsultant.search размещается на любой странице через визуальный редактор. Все настройки (инфоблок, порог релевантности, количество результатов) задаются в модуле, а не в параметрах компонента - так проще управлять.
Покупатель вводит запрос → AJAX-запрос к SearchController → Python-сервис → косинусное сходство → топ-20 товаров → выпадающий список с процентом релевантности.
Примеры поиска
| Каталог | Запрос покупателя | Что находит |
|---|---|---|
| Стройматериалы | штукатурка для влажных помещений | Влагостойкие штукатурки, гидроизоляционные смеси |
| Автозапчасти | масло в двигатель японского авто 5w30 | Моторные масла 5W-30 для азиатских двигателей |
| Зоотовары | корм для пожилой кошки с чувствительным пищеварением | Корма для ageing cats, sensitive digestion |
| Электроника | телефон с хорошей камерой до 40000 | Смартфоны с мощной камерой в бюджете до 40 000 |
| Бытовая техника | чем косить траву на даче | Газонокосилки, триммеры, сенокосилки |
| Косметика | крем от морщин после 45 лет | Антивозрастные кремы 45+ |
Исходный код: gitverse.ru/mibazarow/bitrix-smart-consultatant